openEHR vs FHIR : modèle de stockage ou standard d’échange, et quand combiner les deux
Une comparaison de terrain entre openEHR et HL7 FHIR : modélisation à deux niveaux, AQL et API REST openEHR face aux ressources et profils FHIR, avec des déploiements européens et le schéma CDR openEHR plus façade FHIR.
Ala Ben Aicha
Réponse directe
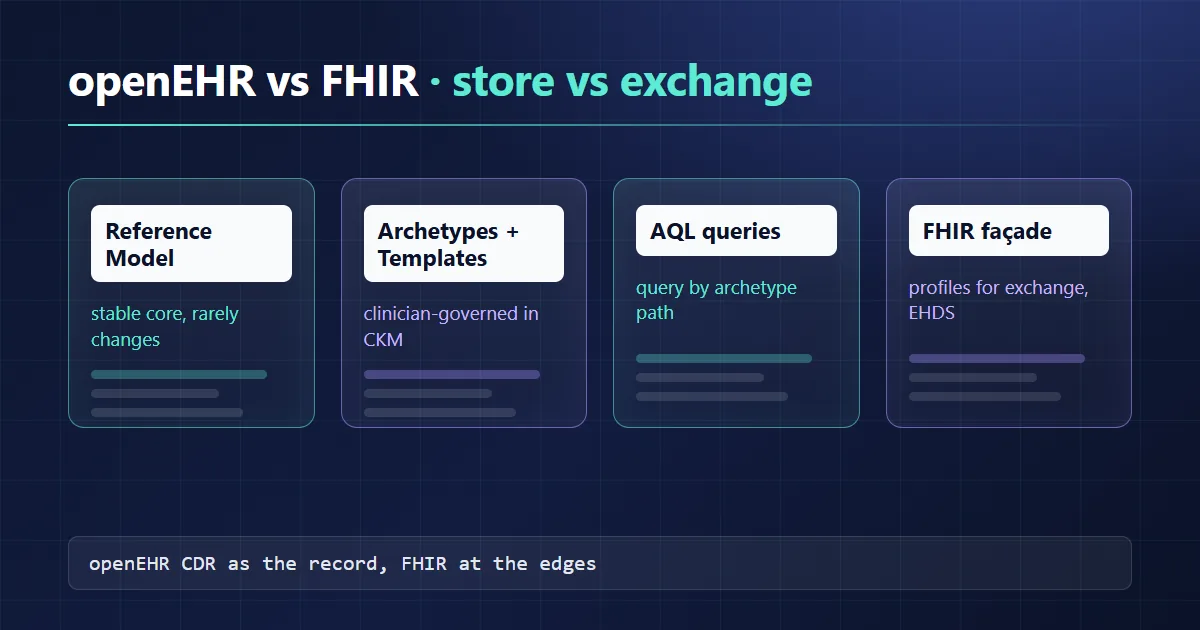
openEHR spécifie comment stocker et interroger un dossier clinique tout au long de la vie du patient : un modèle de référence stable, un contenu clinique défini par des archétypes et des templates, et un langage de requête (AQL) sur ces données. FHIR spécifie comment les systèmes échangent des données : ressources, profils et API REST. Les deux se recouvrent moins que le « vs » ne le laisse croire. Un schéma fréquent en Europe conserve le dossier persistant dans un entrepôt de données cliniques openEHR (CDR) et expose FHIR en périphérie, pour les applications, les partenaires et les échanges EHDS.
Ce que spécifie openEHR
openEHR repose sur une modélisation à deux niveaux. Le logiciel et le contenu clinique sont volontairement séparés.
Niveau 1 : le modèle de référence (RM). Un petit ensemble de classes génériques qui évolue rarement : EHR, COMPOSITION, OBSERVATION, EVALUATION, INSTRUCTION, ACTION, ELEMENT, et des types de données comme DV_QUANTITY et DV_CODED_TEXT. Un CDR, sa couche de persistance et ses API sont écrits uniquement contre le modèle de référence. Le RM porte aussi le versionnage : chaque modification validée devient une nouvelle version, au sein d’une contribution avec ses informations d’audit (qui, quand, pourquoi).
Niveau 2 : archétypes et templates. Un archétype est une contrainte réutilisable sur le RM pour un concept clinique : pression artérielle, problème/diagnostic, prescription médicamenteuse. Les archétypes sont conçus pour être maximaux et couvrir tout ce qu’un clinicien pourrait raisonnablement documenter sur ce concept. Un template combine et restreint des archétypes pour un cas d’usage, par exemple un formulaire de tri aux urgences ou une lettre de liaison de sortie.
Les deux s’écrivent en ADL (Archetype Definition Language). En pratique :
- ADL 1.4 reste le format qu’échangent aujourd’hui la plupart des CDR et des outils de modélisation.
- ADL 2 est la spécification actuelle (ADL2, AM Release 2.3.0, statut stable). Son support reste inégal selon les produits : vérifiez avant de vous engager.
- Operational Template (OPT). Le template compilé et aplati que charge le CDR. C’est le schéma d’exécution. Un OPT ADL 1.4 se dépose en XML avec
POST /definition/template/adl1.4.
Conséquence pratique : quand un établissement a besoin d’un nouveau formulaire, l’équipe charge un nouveau template. Personne ne migre de schéma de base de données.
Clinical Knowledge Manager
Les archétypes sont relus par des cliniciens et publiés dans le Clinical Knowledge Manager international (CKM). Plusieurs pays exploitent leur propre instance de CKM pour le contenu national ; celle de la Norvège est sur arketyper.no. C’est une couche de gouvernance sans équivalent direct côté FHIR : la revue du contenu est assurée par des modélisateurs cliniques, distincts des rédacteurs de la spécification d’API.
AQL : interroger par chemin d’archétype
L’Archetype Query Language (AQL) interroge les compositions et les dossiers (EHR) à l’aide des chemins d’archétypes, quelle que soit l’application ou le template qui a saisi la donnée. La spécification actuelle est AQL dans QUERY Release 1.1.0, qui a ajouté LIMIT et OFFSET. Exemple synthétique qui remonte les mesures de pression artérielle élevées pour un dossier :
SELECT
  c/context/start_time/value AS recorded_at,
  o/data[at0001]/events[at0006]/data[at0003]/items[at0004]/value/magnitude AS systolic,
  o/data[at0001]/events[at0006]/data[at0003]/items[at0005]/value/magnitude AS diastolic
FROM EHR e
  CONTAINS COMPOSITION c
    CONTAINS OBSERVATION o[openEHR-EHR-OBSERVATION.blood_pressure.v2]
WHERE e/ehr_id/value = $ehr_id
  AND o/data[at0001]/events[at0006]/data[at0003]/items[at0004]/value/magnitude >= 140
ORDER BY c/context/start_time/value DESC
LIMIT 10
Les codes at0004 et at0005 sont des identifiants de nœuds de l’archétype de pression artérielle (systolique et diastolique). La même requête renvoie les mesures saisies par une feuille de surveillance en service, un template de médecine générale ou une application de télésurveillance, dès lors que chacun a utilisé cet archétype. Retirez la clause WHERE e/ehr_id/value et elle devient une requête de population, ce qui explique l’intérêt des plateformes de recherche pour openEHR.
L’API REST openEHR
La spécification REST (ITS-REST) définit la surface HTTP qu’expose un CDR. ITS-REST Release 1.1.0 a été publiée en juillet 2026, première version mineure depuis la 1.0.3 de 2022. Elle refond les formats simplifiés (FLAT et structuré) et ajoute une API démographique, une API d’administration et un lancement d’application « SMART on openEHR », ces trois derniers au niveau de maturité « development ». Les appels que la plupart des intégrations utilisent :
| Appel | Rôle |
|---|---|
POST /ehr |
Créer un EHR pour un patient |
POST /ehr/{ehr_id}/composition |
Enregistrer une composition selon un template chargé |
POST /query/aql |
Exécuter une requête AQL ad hoc ; les paramètres vont dans query_parameters |
GET /query/{qualified_query_name} |
Exécuter une requête stockée et versionnée |
Ce que spécifie FHIR
FHIR définit des ressources (Patient, Observation, Condition, MedicationRequest, Encounter et beaucoup d’autres), une API REST, ainsi que des paradigmes messages et documents. Les ressources suivent une logique 80/20 : le cœur couvre ce que la plupart des systèmes stockent déjà, le reste passe par des extensions. Les profils contraignent les ressources pour un contexte et sont publiés dans des guides d’implémentation comme HL7 Europe Base et Core, FR Core ou US Core.
La plupart des projets en production fixent encore FHIR R4 (4.0.1). R6 était en vote normatif en 2026 et n’est pas la version sur laquelle bâtir un échange national aujourd’hui. Pour une vue d’ensemble des ressources, de la recherche et de SMART, commencez par le guide d’intégration HL7 FHIR.
La différence de conception compte : une ressource FHIR est une forme d’échange minimale complétée par des extensions, un archétype openEHR est un modèle clinique maximal restreint par des templates. La correspondance entre les deux perd de l’information dans les deux sens, sauf si quelqu’un décide, champ par champ, de ce que chaque côté signifie.
Différences clés
| Dimension | openEHR | FHIR |
|---|---|---|
| Finalité | Dossier clinique persistant, longitudinal et indépendant des éditeurs | Échange entre systèmes via REST, messages et documents |
| Modèle | Petit RM + archétypes maximaux + templates par cas d’usage | Ressources (80/20) + profils + extensions |
| Granularité | Chaque donnée adressable par chemin d’archétype | Au niveau de la ressource ; le détail dépend du profil et des extensions |
| Versionnage et audit | Intégrés au RM : objets versionnés, contributions, informations d’audit | meta.versionId et _history dépendent du serveur ; Provenance et AuditEvent sont des ressources séparées |
| Requêtes | AQL sur les compositions et les dossiers | Paramètres de recherche par type de ressource, _include, chaînage ; analytique généralement via export bulk |
| Gouvernance | Spécifications openEHR ; contenu clinique relu dans le CKM | Cœur HL7 ; guides publiés par les affiliés HL7, les agences nationales, IHE et des accélérateurs |
| Outillage | CKM, éditeurs d’archétypes et de templates, nombre plus restreint de CDR | Vaste écosystème de serveurs, validateurs, SDK et outils de test |
| Déploiements typiques | CDR nationaux et régionaux, plateformes DPI hospitalières, plateformes de recherche | API patients et professionnels, échanges nationaux, applications SMART, API des payeurs |
Côté CDR, EHRbase est l’option open source la plus connue (Apache 2.0), à côté des plateformes commerciales. Côté FHIR, comparez les serveurs dans Serveurs FHIR comparés.
Là où les deux cohabitent en Europe
Exemples appuyés sur des sources publiques :
- Norvège. La Direction norvégienne de la santé indique que DIPS Arena, le DPI hospitalier de la région Sud-Est, utilise des modèles d’information indépendants des éditeurs fondés sur les archétypes openEHR.
- Slovénie. Le registre national centralisé des données patients stocke ses données en openEHR sur la plateforme Better, avec plus de 250 millions de documents cliniques après dix ans selon Better.
- Catalogne. Le service de santé régional exploite un CDR openEHR à l’échelle de la population, décrit dans le livre blanc de vitagroup sur la Catalogne.
- Royaume-Uni. Le Universal Care Plan de OneLondon fonctionne sur une plateforme openEHR dont la couche de données persistante est séparée des applications (étude de cas Better).
- Allemagne. Les CHU du consortium HiGHmed ont construit des centres d’intégration de données fondés sur openEHR pour la recherche. Le FHIR Bridge open source, intermédiaire entre des clients FHIR et un serveur openEHR, est issu du réseau allemand de médecine universitaire.
Plusieurs de ces sources sont des publications d’éditeurs. Considérez les chiffres comme déclarés par l’éditeur.
Schémas de combinaison
1. CDR openEHR comme stockage, façade FHIR pour l’échange. Les applications écrivent des compositions via des templates. Une façade convertit certains archétypes en profils FHIR en lecture (et parfois en écriture). Partenaires, applications SMART et services nationaux voient du FHIR. Cliniciens et analystes gardent l’AQL.
2. Moteurs de mapping plutôt que code écrit à la main. FHIRconnect est un langage de mapping en YAML pour des correspondances bidirectionnelles openEHR–FHIR. Better l’a lancé, a cessé de maintenir son dépôt d’origine en 2024, et la spécification communautaire vit désormais dans le dépôt FHIRconnect-spec. L’article de 2025 de ses auteurs fait état de 24 archétypes internationaux mappés vers 15 profils FHIR. openFHIR, annoncé d’abord par Medblocks en 2025, est un moteur Apache 2.0 qui exécute les mappings FHIRconnect sans stocker lui-même de données cliniques. Son README précise que l’édition open source n’est pas destinée à la production (pas d’authentification ni d’intégration à un serveur de terminologie). Versionnez les fichiers de mapping comme du code.
3. Serveur FHIR comme stockage, sans openEHR. Pertinent quand le produit est une application ou un hub d’échange au périmètre de données étroit. Vous renoncez à l’AQL et à la gouvernance des archétypes, et les extensions s’accumuleront à mesure que le périmètre grandit.
Pertinence pour l’EHDS
Dans l’EHDS, le format européen d’échange des dossiers de santé informatisés (EEHRxF) encadre l’échange, pas le stockage. La Commission doit adopter d’ici le 26 mars 2027 les actes d’exécution qui en fixent les spécifications techniques, et ceux-ci devraient s’appuyer sur les guides d’implémentation FHIR de HL7 Europe. Tant que les actes ne sont pas adoptés, considérez-le comme une orientation, pas comme une obligation. Un DPI fondé sur openEHR aura donc besoin d’une voie d’export FHIR pour les synthèses patient, les prescriptions et dispensations électroniques, les résultats de biologie, les comptes rendus d’imagerie et les lettres de liaison de sortie. Voir FHIR EU Core et EHDS pour les guides et le guide EHDS pour les échéances et les obligations.
Aide à la décision
| Situation | Orientation |
|---|---|
| Région ou groupement hospitalier qui veut un dossier pérenne, indépendant des éditeurs, qui survive aux applications | CDR openEHR, plus une façade FHIR |
| Produit qui lit et écrit principalement via les API d’autres systèmes | FHIR seul |
| Plateforme de recherche ou registre qui a besoin de modèles gouvernés par des cliniciens et de requêtes multi-patients | openEHR (AQL), FHIR pour l’alimentation et l’export |
| Échange national, EHDS, exigences des payeurs américains ou de l’ONC | FHIR obligatoire à la frontière, quel que soit le stockage interne |
| Équipe sans modélisateurs cliniques | FHIR d’abord ; openEHR sans capacité de modélisation s’enlise |
Échecs fréquents en pratique :
- Mapper trop tard. L’équipe construit le CDR, puis découvre qu’un profil FHIR exige un système de codes ou une cardinalité que son template n’a jamais capturés. Mappez les profils FHIR prioritaires pendant la conception des templates.
- Des archétypes locaux partout. Dupliquer les archétypes du CKM par confort détruit le bénéfice de l’AQL entre systèmes. Spécialisez ou étendez plutôt.
- Deux sources de vérité. Si la façade FHIR accepte aussi des écritures, définissez quel côté fait foi et comment les conflits sont versionnés.
- Négliger la terminologie. Les deux côtés ont besoin de liaisons SNOMED CT, LOINC et CIM ; aucun des deux formats ne corrige des codes locaux. L’introduction à l’interopérabilité traite de la couche terminologique.
Si vous hésitez entre un stockage FHIR natif et un CDR openEHR, ou si vous concevez la couche de mapping entre les deux, c’est le type de travail d’architecture couvert par l’accompagnement en interopérabilité de la santé numérique.