De FHIR à OMOP CDM : construire un pipeline de données de santé exploitable pour la recherche
Le parcours d’un pipeline FHIR vers OMOP vu par un ingénieur intégration : export Bulk Data, zone de staging, mapping des vocabulaires avec Athena, chargement des tables du CDM et contrôles qualité, avec les pièges qui font échouer les études.
Ala Ben Aicha
Réponse directe
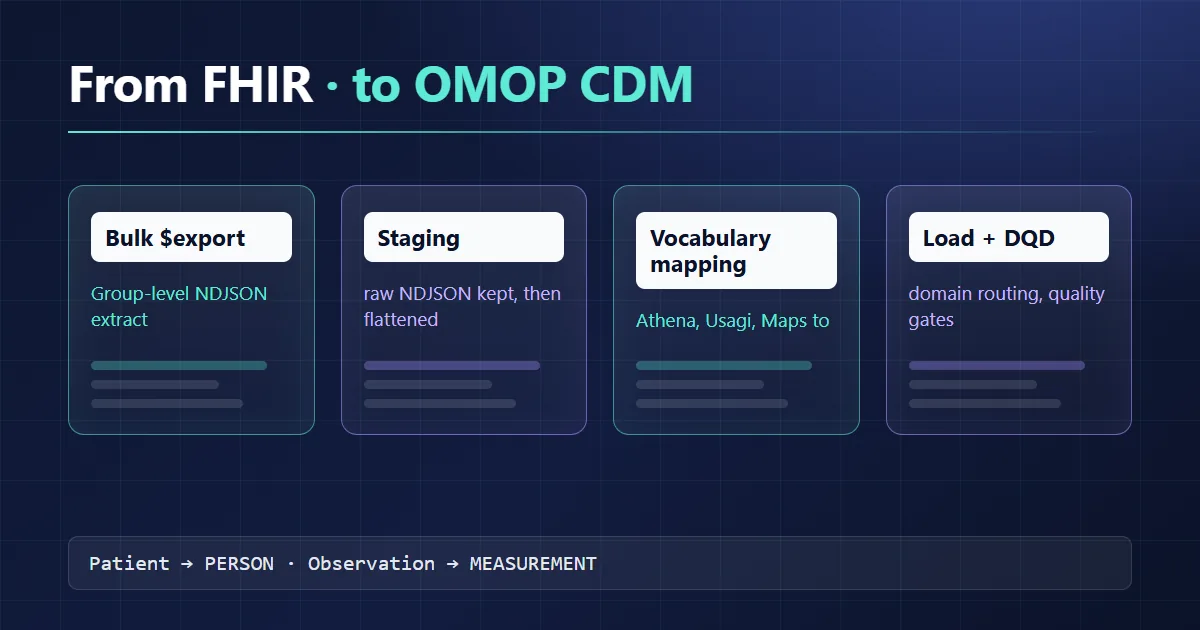
Un pipeline FHIR vers OMOP extrait les ressources FHIR en masse, les dépose telles quelles dans une zone de staging, rattache chaque code à un concept standard OHDSI, puis charge le résultat dans les tables du CDM OMOP choisies selon le domaine du concept, et non selon le type de ressource FHIR. Patient devient PERSON, Encounter devient VISIT_OCCURRENCE, Condition devient CONDITION_OCCURRENCE, et Observation se répartit entre MEASUREMENT et OBSERVATION. Visez OMOP CDM v5.4, sauf si votre réseau de recherche est passé à la v5.5, conservez les codes d'origine dans les champs _source_value et _source_concept_id, et lancez le Data Quality Dashboard avant que quiconque ne lance une étude.
Pourquoi OMOP, et quelle version
FHIR est conçu pour l'échange : un patient, une transaction, l'état courant. OMOP est conçu pour l'analyse de millions de patients avec un SQL identique sur chaque site. C'est pour cela que le réseau DARWIN EU de l'EMA demande à ses partenaires de données de standardiser vers le modèle commun OMOP, et qu'un établissement qui expose déjà des API FHIR veut souvent une copie OMOP pour la recherche, par exemple pour alimenter un entrepôt de données de santé.
Le choix de version en octobre 2026 :
- Le site du CDM OMOP indique la v5.5 comme version actuelle. Ses changements depuis la v5.4 sont additifs : sept champs optionnels (par exemple
value_as_source_concept_iddans MEASUREMENT), trois tables de métadonnées de vocabulaire, rien de supprimé ni de renommé. - Le Vulcan FHIR to OMOP Implementation Guide de HL7 (v1.0.0, informatif, publié par le groupe de travail Biomedical Research and Regulation) cible la v5.4, et sa page de contexte sur le CDM rappelle que la communauté OHDSI a arrêté le développement de la v6.0 en 2022.
En pratique : construisez sur les colonnes de la v5.4, qu'une base v5.5 accepte aussi, et ajoutez les champs v5.5 lorsque votre réseau et vos outils les attendent.
Architecture du pipeline
| Étape | Ce qui se passe | Outillage habituel |
|---|---|---|
| 1. Extraction | Export Bulk Data au niveau Group, incrémental avec _since |
$export du serveur FHIR, jeton SMART Backend Services |
| 2. Staging | NDJSON déposé tel quel, puis aplati en tables de staging | Stockage objet, Parquet, vues SQL |
| 3. Mapping des vocabulaires | Codes sources vers concepts standard ; codes locaux revus | Vocabulaires Athena, Usagi, concepts personnalisés |
| 4. Chargement | Routage par domaine, clés entières, dérivation d'OBSERVATION_PERIOD | SQL ou dbt, Spark pour les gros volumes |
| 5. Contrôle | Conformité, complétude, plausibilité | Data Quality Dashboard, ACHILLES |
L'extraction s'appuie sur le lancement défini par FHIR Bulk Data Access. Exporter un Group correspondant à la cohorte de recherche évite les extractions de tout le système :
GET /fhir/Group/research-cohort-01/$export?_type=Patient,Encounter,Condition,Observation,MedicationRequest,Procedure&_since=2026-09-01T00:00:00Z HTTP/1.1
Host: fhir.example.org
Accept: application/fhir+json
Prefer: respond-async
Authorization: Bearer <backend-services-token>
Le serveur répond 202 Accepted avec une URL de statut dans Content-Location ; vous l'interrogez jusqu'à obtenir un manifeste listant les fichiers NDJSON par type de ressource. Le support varie selon les serveurs, vérifiez-le avant de bâtir votre conception dessus (voir serveurs FHIR comparés).
Conservez le NDJSON brut. Quand une règle de mapping changera six mois plus tard, vous rejouerez les étapes 3 à 5 depuis le staging, sans réextraire depuis la production.
Correspondance ressources et tables
| Ressource FHIR | Table OMOP | Champs cibles clés | Points d'attention |
|---|---|---|---|
| Patient | PERSON (+ DEATH) | gender_concept_id, year_of_birth, person_source_value |
Ne jamais mettre l'IPP réel ni l'INS dans person_source_value |
| Encounter | VISIT_OCCURRENCE (+ VISIT_DETAIL) | visit_concept_id à partir de Encounter.class, dates de début et de fin |
Les mutations entre unités vont dans VISIT_DETAIL |
| Condition | CONDITION_OCCURRENCE | condition_concept_id, date de début issue de l'onset ou de la date d'enregistrement |
Filtrer entered-in-error et les statuts de vérification réfutés |
| Observation | MEASUREMENT ou OBSERVATION | measurement_concept_id, value_as_number, unit_concept_id |
Le routage dépend du domaine du concept standard |
| MedicationRequest / MedicationStatement | DRUG_EXPOSURE | drug_concept_id (RxNorm ou RxNorm Extension), drug_type_concept_id |
Une prescription ne prouve pas que le médicament a été pris |
| Procedure | PROCEDURE_OCCURRENCE | procedure_concept_id, procedure_date |
Exclure les actes planifiés ou non réalisés |
L'IG rattache aussi Immunization à DRUG_EXPOSURE et AllergyIntolerance à OBSERVATION. Deux tables n'ont aucune ressource FHIR derrière elles et comptent pourtant : OBSERVATION_PERIOD (exigée par la plupart des analyses OHDSI, à dériver de la première et de la dernière activité enregistrée, ou des dates d'inclusion si vous les avez) et CDM_SOURCE.
Mapping des concepts : source_concept_id contre concept_id
Chaque table clinique porte deux colonnes de concept, et les confondre est le bug d'ETL le plus fréquent.
measurement_source_concept_idcontient le concept du code reçu, standard ou non. Un code LOINC va ici, tout comme un code de laboratoire local que vous avez déclaré comme concept personnalisé.measurement_concept_idcontient le concept standard atteint en suivant la relationMaps tode CONCEPT_RELATIONSHIP. C'est sur cette colonne que tournent les analyses. Sans mapping, la valeur est0, jamais NULL et jamais le concept source.
Le domain_id du concept standard détermine la table. Un code SNOMED CT envoyé dans une ressource Condition peut correspondre à un concept du domaine Observation (un antécédent, par exemple) et doit atterrir dans OBSERVATION, pas dans CONDITION_OCCURRENCE. La qualité des codes en amont décide de la part automatisable ; la couche de mapping décrite dans HL7 v2 vers FHIR avec LOINC et SNOMED CT est rentabilisée une seconde fois ici.
Exemple concret : un résultat de biologie dans MEASUREMENT
Une Observation FHIR synthétique, déjà pseudonymisée en staging :
{
  "resourceType": "Observation",
  "id": "obs-000123",
  "status": "final",
  "code": { "coding": [{ "system": "http://loinc.org", "code": "2345-7", "display": "Glucose [Mass/volume] in Serum or Plasma" }] },
  "subject": { "reference": "Patient/pseudo-7f3a" },
  "encounter": { "reference": "Encounter/pseudo-enc-91" },
  "effectiveDateTime": "2026-09-14T08:30:00+02:00",
  "valueQuantity": { "value": 104, "unit": "mg/dL", "system": "http://unitsofmeasure.org", "code": "mg/dL" }
}
Une fois aplatie dans staging.observation, le chargement résout les concepts à partir des tables de vocabulaire au lieu de coder les identifiants en dur (syntaxe PostgreSQL) :
-- Synthetic example: staged FHIR Observations into OMOP CDM v5.4 MEASUREMENT
INSERT INTO cdm.measurement (
  measurement_id, person_id, measurement_concept_id, measurement_date,
  measurement_datetime, measurement_type_concept_id, value_as_number,
  unit_concept_id, visit_occurrence_id, measurement_source_value,
  measurement_source_concept_id, unit_source_value
)
SELECT
  nextval('cdm.measurement_id_seq'),
  p.person_id,
  COALESCE(std.concept_id, 0),
  CAST(o.effective_at AS date),
  o.effective_at,
  32817,                                  -- Type Concept 'EHR'
  o.value_number,
  COALESCE(u.concept_id, 0),
  v.visit_occurrence_id,
  o.code,                                 -- original source code
  COALESCE(src.concept_id, 0),
  o.unit_code
FROM staging.observation o
JOIN cdm.person p
  ON p.person_source_value = o.patient_pseudo_id
LEFT JOIN cdm.visit_occurrence v
  ON v.visit_source_value = o.encounter_pseudo_id
LEFT JOIN vocab.concept src
  ON src.vocabulary_id = 'LOINC' AND src.concept_code = o.code
LEFT JOIN vocab.concept_relationship cr
  ON cr.concept_id_1 = src.concept_id
 AND cr.relationship_id = 'Maps to'
 AND cr.invalid_reason IS NULL
LEFT JOIN vocab.concept std
  ON std.concept_id = cr.concept_id_2 AND std.standard_concept = 'S'
LEFT JOIN vocab.concept u
  ON u.vocabulary_id = 'UCUM' AND u.concept_code = o.unit_code
WHERE o.code_system = 'http://loinc.org'
  AND o.status IN ('final', 'amended', 'corrected')
  AND COALESCE(std.domain_id, src.domain_id) = 'Measurement';
Les lignes qui échouent au filtre de domaine partent vers le chargement d'OBSERVATION ; les codes absents des deux jointures vont dans un backlog de mapping, et non silencieusement dans le concept 0 pour toujours. La valeur 32817 est le concept de type EHR qu'utilise la StructureMap de mesure de l'IG lui-même ; vérifiez-la dans votre version d'Athena.
L'outillage OHDSI que vous utiliserez vraiment
| Outil | Rôle dans le pipeline |
|---|---|
| Athena | Télécharger les vocabulaires standardisés (SNOMED CT, LOINC, RxNorm, UCUM et d'autres ; certains exigent une licence) |
| WhiteRabbit | Profiler les tables sources avant le mapping |
| Rabbit-in-a-Hat | Documenter les correspondances de tables et de champs ; il produit des spécifications, pas du code |
| Usagi | Proposer des mappings pour les codes locaux par similarité textuelle ; un humain valide |
| ACHILLES | Caractériser le CDM chargé pour la revue et pour ATLAS |
| Data Quality Dashboard | Exécuter les contrôles de conformité, complétude et plausibilité, table par table |
Tous figurent sur la page logiciels d'OHDSI. Traitez une exécution du DQD comme une porte de mise en production, pas comme un rapport qu'on lira plus tard.
Les pièges qui font échouer les études
- Codes locaux. En Europe, les codes de biologie et de médicaments sont souvent locaux. Déclarez-les comme concepts personnalisés (identifiants supérieurs à 2 000 000 000, jamais standard, utilisés seulement dans les champs
_source_concept_id) et reliez-les à des concepts standard avecMaps to. Un code local non mappé est invisible pour les études en réseau. - Unités. Utilisez le code UCUM de
valueQuantity.code, pas le libelléunit. UCUM est sensible à la casse, et unmmol/lvenu d'un flux historique ne correspondra pas. Ne convertissez pas les valeurs en silence ; si vous normalisez, documentez la règle. - Statut et intention. FHIR transporte des brouillons, des plans, des annulations et des erreurs. Filtrez-les délibérément. La page des difficultés courantes de l'IG couvre le statut, l'intention, les identifiants et la précision temporelle.
- Décalage des dates. Un décalage constant par personne préserve les intervalles mais casse la saisonnalité, les fenêtres d'exposition calendaires et tout ce qui dépend d'une date réelle, comme une campagne de vaccination. Validez-le avec l'équipe d'étude avant le chargement.
- Pseudonymisation et RGPD. Des données pseudonymisées restent des données personnelles au sens du RGPD. Gardez la clé de réidentification hors de l'environnement OMOP, nettoyez les champs
_source_valueen texte libre, et lisez les recommandations OHDSI sur la confidentialité. Le volet architecture est traité dans une architecture de données de santé conforme au RGPD. - Clés instables. Les clés OMOP sont des entiers. Maintenez une table de correspondance persistante entre identifiants logiques FHIR et identifiants OMOP, pour que les chargements incrémentaux mettent à jour au lieu de dupliquer.
L'angle européen
Le règlement EHDS est entré en vigueur le 26 mars 2025, et ses règles d'usage secondaire s'appliquent à partir de mars 2029 pour la plupart des catégories de données, l'accès étant accordé par des organismes d'accès aux données de santé. Le règlement n'impose pas OMOP. Mais un détenteur de données capable de produire déjà, à partir de ses flux FHIR, un jeu OMOP documenté et contrôlé répondra plus vite aux demandes d'accès, et pourra participer à des études fédérées de type DARWIN EU sans projet séparé. Le contexte EHDS est détaillé dans le guide EHDS.
Si vous préparez un pipeline FHIR vers OMOP et cherchez de l'aide sur l'extraction, le mapping des vocabulaires ou les contrôles qualité, c'est le périmètre d'un accompagnement en analyse de données de santé.